AI视觉算法在工业安防管控系统中的落地实践与选型建议
走进任意一座大型化工园区或智能制造工厂,你会发现,过去两年里“AI视觉”已经从PPT上的概念图,变成了中控大屏里跳动着的实时告警框。但与此同时,一个尴尬的现实正在发生:同一套算法模型,在A厂识别准确率高达98%,搬到B厂却频频误报,甚至被一线安全员直接关闭。
为什么“通用模型”在工业场景总失灵?
根源在于工业现场的**非结构化特征**。车间光照会随天窗角度变化,粉尘颗粒会附着在镜头表面,叉车与人员的身影会因透视关系产生重叠——这些干扰,是标准公开数据集里根本无法穷尽的。南京脑一代智能科技有限公司在承接某汽车零部件产线项目时发现,客户此前采购的“大厂通用盒子”,对反光背心的检测阈值是固定的,结果下午三点的侧逆光就能让整套系统陷入瘫痪。
真正的解法,并非堆叠更多算力,而是让算法学会“理解物理世界的干扰逻辑”。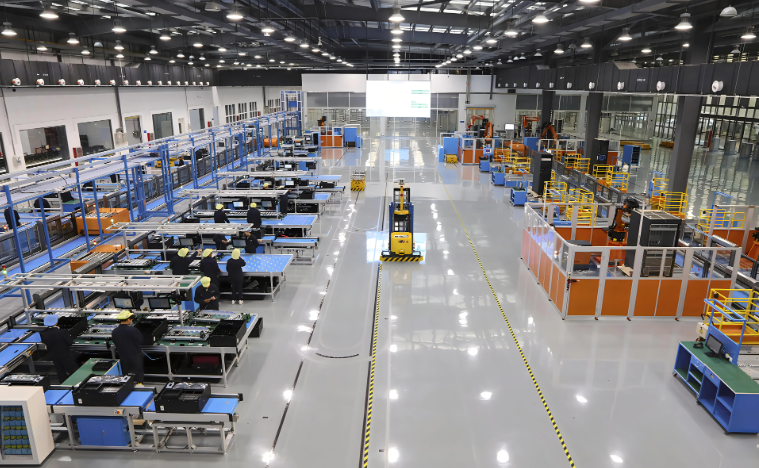
技术解析:从“像素匹配”到“语义推理”
这便牵扯出AI视觉落地中的两条技术路径。其一是传统的**目标检测框架**(如YOLO系列),它擅长捕捉“有没有”,但无法回答“为什么场景变了”。其二是我们更推荐的**语义分割+时序行为分析**组合。以南京脑一代智能科技有限公司的实践为例,我们在某钢铁厂部署了一套基于Transformer架构的时序模型,通过连续30帧的行为轨迹预测,将皮带跑偏的误报率从每周47次压降至3次以内——这背后依赖的,正是对设备振动频率与物料流速的大数据分析,而非单纯的画面判断。
当然,这里必须提及一个残酷的工程现实:没有一套算法能脱离场景调优而直接商用。哪怕是行业头部的视觉平台,也需要至少两周的现场数据采集与标注周期。这恰恰是很多企业选型时的最大盲区——他们误以为“AI 应用”是开箱即用的软件,却忽略了它本质上是一个需要持续迭代的智能系统研发过程。
选型建议:别被“准确率99%”的话术绑架
作为常年在一线做交付的技术团队,我们给出三个具体建议。第一,要求厂商提供“误报率/漏报率权衡曲线”,而非单一准确率数字——在工业安防中,一次漏报可能意味着安全事故,而十次误报则会训练员工对警报产生麻木,两者代价完全不同。第二,验证算法对极端光照与遮挡的鲁棒性,方法是让对方用你们工厂的现场视频片段现场跑一遍推理,而不是看对方精心剪辑的Demo视频。第三,也是容易被忽略的,确认后台是否具备模型热更新能力——产线一旦调整工位,算法能否在数小时内通过新标注数据完成微调,直接决定了项目的长期ROI。
南京脑一代智能科技有限公司在开发自己的智能设备开发框架时,特意将“场景适配工具链”做成了可视化拖拽界面,让客户的安全主管也能参与阈值调整,这远比黑盒式的算法包更易落地。事实上,我们为某电力巡检项目部署的边缘计算单元,已经连续无故障运行了11个月,期间通过远程更新完成了3次模型迭代,而硬件设备本身未曾重启。
值得一提的是,工业安防的终极形态并非“事后识别”,而是“事前预警”。我们正在尝试将脑力训练软件中积累的注意力机制模拟算法,迁移到对监控员疲劳状态的辅助判断上——当系统检测到值守人员视线偏离屏幕超过20秒时,自动调高画面告警音的音调。这个跨界思路,或许会为行业打开一扇新的门。
选型从来不是技术参数的比拼,而是对自身生产场景认知深度的较量。与其追逐一个“万能”的AI平台,不如找到能与你共同理解现场噪声、光照、甚至工人操作习惯的合作伙伴。毕竟,算法会迭代,设备会更新,而对复杂场景的敬畏心,才是智能安防真正的地基。